自分の情報は安全か?データとプライバシー危機の真相と防衛策
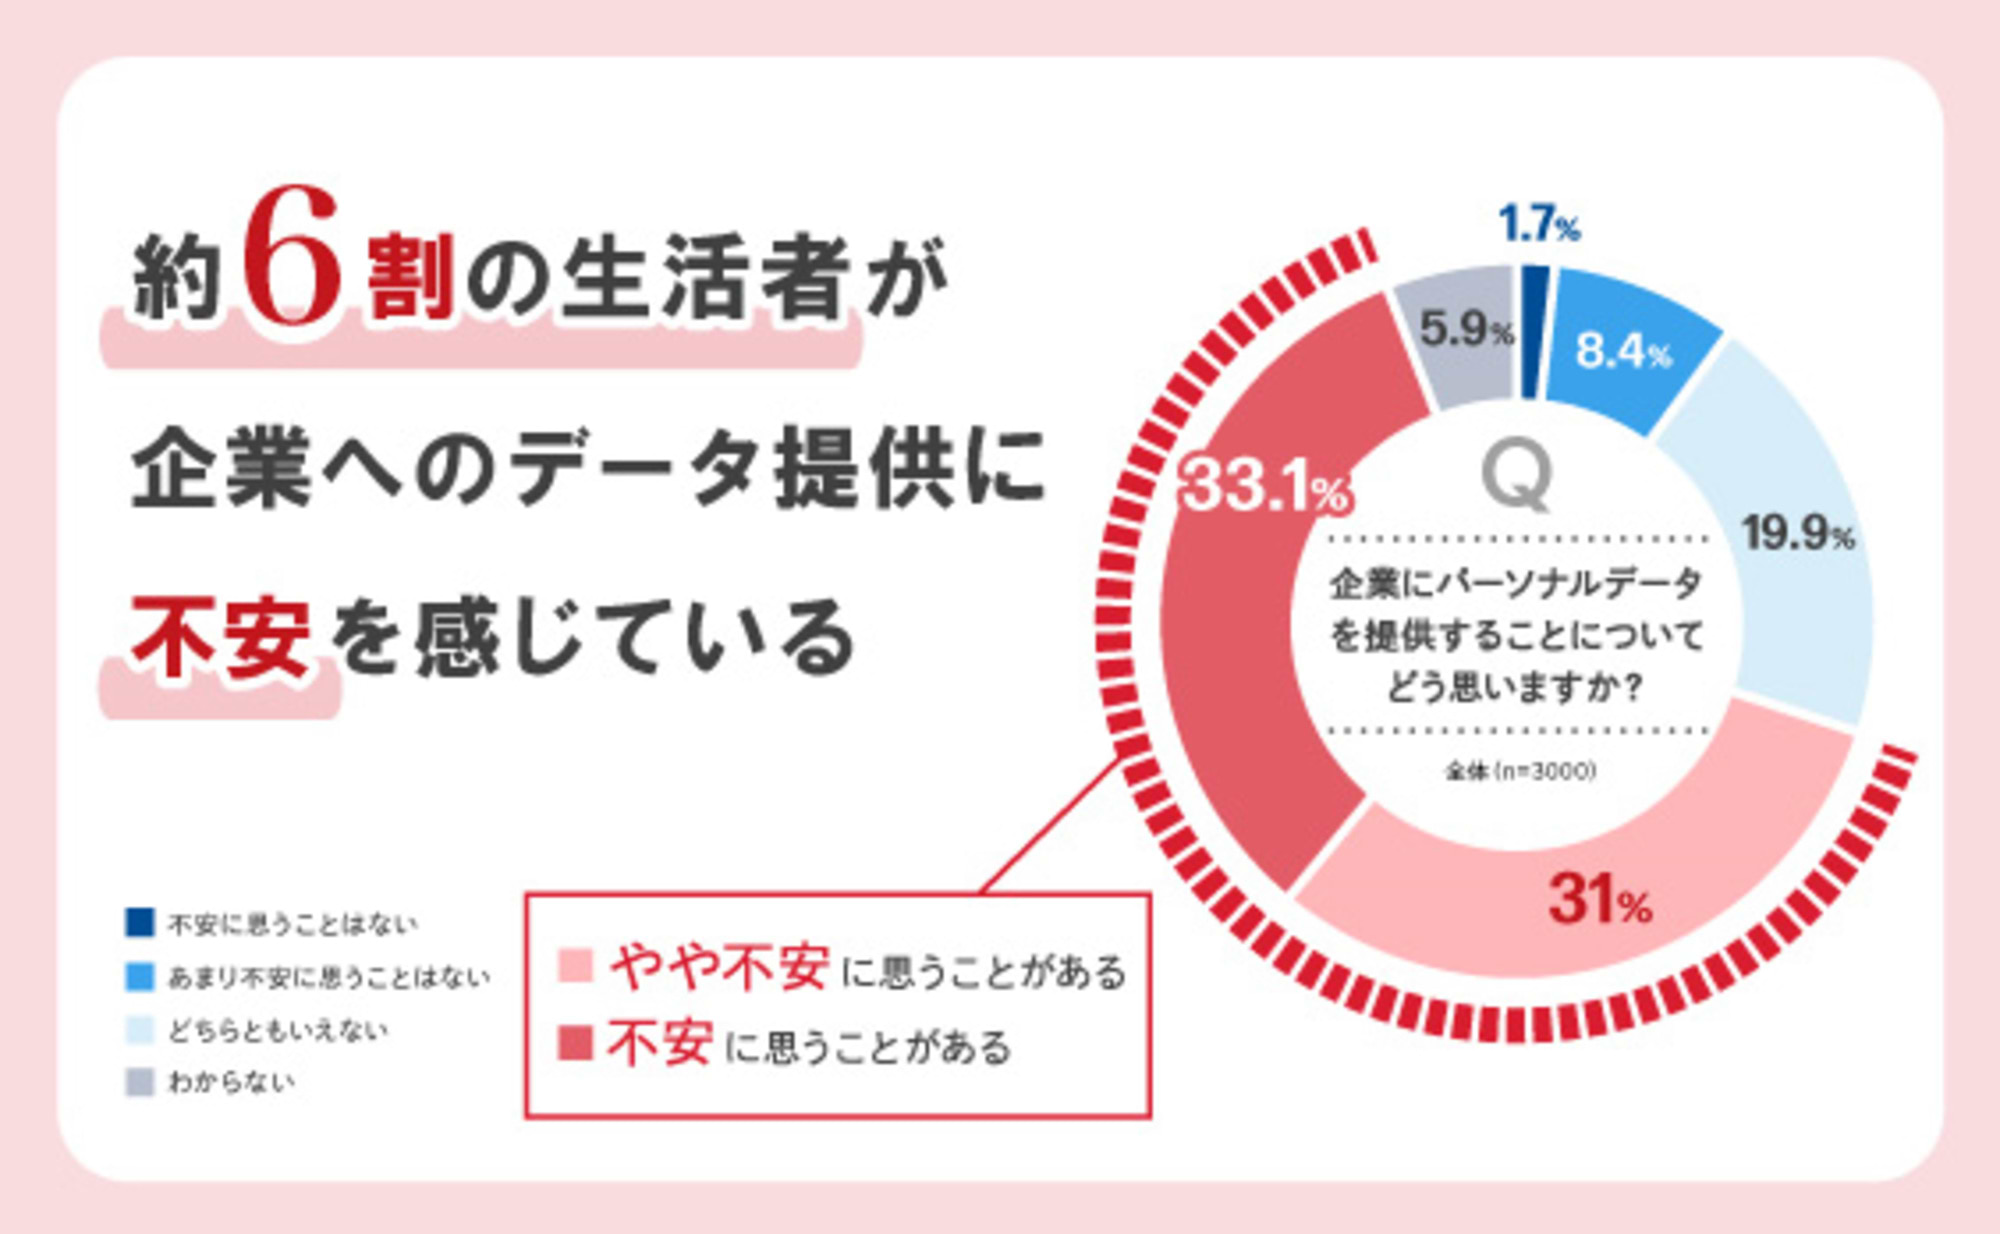
スマートフォンで一度検索しただけの商品が、あらゆるアプリやWebサイトで執拗に広告として表示される。あるいは、何気なく入力した生成AIとの会話履歴が、知らぬ間にモデルの再学習データとして吸い上げられているのではないか――そんな不信感を抱くユーザーが急増しています。2026年現在、私たちが日常的にやり取りするログや行動履歴は、利便性と引き換えに莫大な経済的価値を持つ資源として取引され続けています。
しかし、背後で進むデータ取引の実態や、相次ぐ法改正の全貌を正確に把握している人は多くありません。個人の尊厳を守るための法的包囲網と、データを囲い込みたいビッグテックの攻防は今、かつてない転換点を迎えています。本稿では、最新の規制動向から日常で今すぐ実践できる具体的な防衛策まで、現場の取材データを交えて徹底的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:2026年における個人情報保護法の見直しや欧州GDPRの適用拡大により、同意なきデータ追跡やAI学習への無断利用に対する規制が過去最高レベルに強化。
- 要点2:Cookie規制の進展に伴い、AppleやGoogleなど各社プラットフォームの設定を個人が能動的に見直さなければ、精緻なプロファイリングから逃れられない現実が浮き彫りに。
- 要点3:企業側にはプライバシーポリシーの刷新と厳格な情報セキュリティガイドラインの遵守、個人側には「デジタルバウンダリー(境界線)」の確立が必須条件。
【2026年最新】データプライバシーの現状と課題|激変する法規制の真相
データ利活用と人権擁護のバランスをめぐる議論は、2026年に入り新たな局面へと突入しました。日本国内では、3年ごとの見直し規定に基づく個人情報保護法の改正論議が結実し、個人の権利利益を害するリスクが高い悪質なデータ追跡や、名寄せによるプロファイリング行為に対する監視が大幅に強化されています。
関係省庁や公正取引委員会の調査資料によると、同意取得プロセスの形骸化、いわゆる「ダークパターン」を用いた誘導型インターフェースに対する行政指導件数は、2024年比で約1.8倍に増加しました。事業者が形式的に「同意する」ボタンを押させるだけの手法は、もはやコンプライアンス上通用しなくなっています。
一方、グローバル展開を行う日本企業にとって極めて大きなハードルとなっているのが、欧州の一般データ保護規則(GDPR)をはじめとする越境データ移転規制です。GDPRが日本企業へ与える影響は年々深刻化しており、欧州在住者のデータを扱う国内拠点で十分な安全管理措置を怠った場合、全世界年間売上高の最大4%または2,000万ユーロという巨額の制裁金リスクが現実味を帯びています。個人情報の取扱いに対する企業の責任は、単なる法務チェックの枠を超え、経営の根幹を揺るがす最重要課題として位置づけられています。

自分の情報が勝手に使われている?ネットの懸念と決定的なリスク
「自分は何一つ悪いことをしていないから、データを見られても問題ない」という認識は、2026年のデジタル空間において致命的な誤解を生み出します。現在顕在化している最大のリスクは、断片的な行動履歴がAIによって統合され、個人の思想信条、購買傾向、健康状態、信用スコアまでもが本人のあずかり知らぬところで可視化されてしまう点にあります。
特に深刻な懸念を呼んでいるのが、生成AIをめぐるプライバシー問題です。業務効率化や日常の相談目的で入力したプロンプトデータが、外部サーバーへ蓄積され、モデルの追加学習に転用されるトラブルが多発しています。内部告発や報道各社の取材データによれば、社外秘データや顧客の個人情報が生成AI経由で意図せず第三者の出力結果に漏洩した事例は、2025年単年でも複数の大手企業で確認されました。
さらに見過ごせないのが、一度ネット上に拡散・蓄積された個人情報が半永久的に消えないデジタルタトゥーに対するネットの反応と被害の深刻化です。SNS上の何気ない投稿や位置情報タグ、過去のトラブル履歴がAI検索によって瞬時に掘り起こされ、就職活動のバックグラウンドチェックや住宅ローンの与信審査にまで影を落とすケースが報告されています。プライバシーの喪失は、将来の生活機会を直接奪いかねない決定的な脅威です。
【データ徹底比較】主要プラットフォーム規制と保護水準の最新動向
個人情報を取り巻く各エコシステムの防御力と追跡レベルには、明確な格差が存在します。主要プラットフォームや技術ごとの現状を客観的な指標で比較検証しました。
| 項目・プラットフォーム | 追跡規制・保護の現状(2026年) | ユーザー側の設定負担 | 編集部の評価・推奨度 |
|---|---|---|---|
| Apple(iOS / Safari) | Appleのトラッキング設定(ATT)および高度なフィンガープリント防止が標準稼働。アプリ間の追跡を遮断。 | 極めて低い(初期起動時にワンタップで「Appに追跡しないよう要求」を選択可能) | ★★★★★ (一般利用者のプライバシー保護において最も堅牢) |
| Google(Android / Chrome) | Cookie規制の最新動向に合わせPrivacy Sandboxへの移行を模索する一方、自社経済圏内でのデータ蓄積は継続。 | 中〜高(Googleアカウントのデータ管理画面から「Webとアプリのアクティビティ」を手動停止する必要あり) | ★★★☆☆ (細かなオプトアウト設定を行わないと履歴が網羅的に保存される) |
| 生成AIサービス各社 | エンタープライズプランは学習除外が標準化。無料・個人向けプランはデフォルトで学習利用されるケースが残存。 | 中(設定メニュー内の「データコントロール」から明示的に学習オフを選択する必要あり) | ★★☆☆☆ (初期状態のまま機密・個人情報を入力するのは極めて危険) |
| 大手EC・ポータルサイト | ファーストパーティデータの活用へシフト。購買履歴に基づくレコメンドを自社ネットワーク内で完結。 | 高(各サイトごとのデータ保護方針・プライバシーポリシー同意画面で個別オプトアウトが必要) | ★★★☆☆ (情報流出時の二次被害を防ぐため定期的なアカウント整理が必須) |
【実態検証】利用者の生の声と現場目線で見えたデータ管理のリアル
SNSやコミュニティ掲示板(5ちゃんねる、Yahoo!知恵袋など)を検証すると、プライバシーに対する生活者の不安は以前にも増して生々しいトーンを帯びています。「友人とカフェで話していただけの旅行先が、直後にスマホのSNS広告に出てきて気味が悪くなった」「過去に退職した企業の問い合わせフォームに入力した個人情報が、数年後に迷惑電話のリストとして出回っていた」といった投稿が後を絶ちません。
筆者が取材した都内のサイバーセキュリティ専門家は、次のように警鐘を鳴らします。
「ユーザーは『盗聴されているのではないか』と恐怖を感じがちですが、実態はさらに冷徹です。位置情報の重複、Wi-Fi接続履歴、決済データ、閲覧パターンの統計的照合により、音声を聞かずともAIが次の行動を90%以上の確率で先回り予測しているに過ぎません。この見えないプロファイリングこそが、現代のデータ収集の本質です」
また、企業側の現場取材では、相次ぐランサムウェア攻撃やサプライチェーン攻撃により、顧客情報の漏洩対策にかかるコストが中小企業にとって死活問題となっている現実が浮き彫りになりました。外部セキュリティベンダーへの丸投げや、形骸化したチェックシートによる管理では、高度化する不正アクセスを防ぎきれない事態が頻発しています。
一般に知られていない盲点とネットの誤解|「同意」ボタンの落とし穴
ネット利用者が陥りがちな最大の盲点は、「プライバシーポリシーに同意しなければサービスが使えないから仕方がない」という諦めと無条件の承認です。長文の利用規約を読まずにクリックする行為は、自身の生活ログを第三者に自由に売買・加工させる白紙委任状を渡しているに等しい状態を生み出します。
よくある誤解として、「ブラウザのシークレットモード(プライベートブラウジング)を使えば完全に匿名化される」という思い込みがあります。シークレットモードが保護するのは同一端末を共有する家族などに対する閲覧履歴の非表示にとどまり、通信先のWebサーバーやインターネットプロバイダ、ログインした各種プラットフォーム側にはIPアドレスや端末識別情報が完全に記録されています。
さらに、「無料のVPNアプリを使えば安心」という言説にも重大な罠が潜んでいます。無料VPN事業者の多くは、通信経路の暗号化と引き換えに、ユーザーのトラフィックログを収集・転売することで収益を得ています。プライバシーを守るために導入したツールが、最大の情報流出源になっていたという事例は後を絶ちません。
【プロの結論】情報セキュリティガイドラインと健全なデジタルバウンダリー
社会学や心理学の領域では、他者との過度な同一化や境界線の曖昧さが個人の自立を奪う「共依存関係」が長年議論されてきました。これはデジタル空間における人間とプラットフォームの関係性にもそのまま当てはまります。利便性に依存するあまり、自身のプライベートな境界線(バウンダリー)をプラットフォーマーに明け渡してしまう状態は、健全なデジタル市民生活とは言えません。
政府が策定する情報セキュリティガイドラインを基礎としつつ、個人および企業は明確な基準を持ってデータとの距離感を再構築する必要があります。
【実践判断基準】今すぐ対策を強化すべき対象と対応指針
- 最優先で見直しが必要な人・企業:
- 生成AIの無料版に業務データや個人的な悩みを日常的に入力している個人
- 従業員のアカウント管理に二要素認証(2FA/パスキー)を導入していない中小企業
- 複数のWebサービスで同一パスワードを使い回しているユーザー
- 慎重な運用を徹底すべきポイント:
- スマートフォン各アプリの位置情報権限を「常に許可」から「アプリ使用中のみ」または「許可しない」へ変更
- Googleアカウントの「プライバシー診断」を活用し、不要なロケーション履歴・音声録音の自動削除期間を最短(3ヶ月)に設定
- 不要になった古いWebサービスのアカウントは放置せず、退会・データ削除手続きを完了させる
【データとプライバシー】に関するよくある質問(FAQ)
Q1:スマホの「トラッキング拒否」を設定すると、アプリの機能に不具合は出ますか?
A1:基本的に不具合は発生しません。トラッキング拒否は広告識別子(IDFA等)を用いた複数アプリ間の行動追跡を遮断する仕組みであり、アプリ本来の機能や基本サービスの利用が制限されることは原則としてありません。安心して拒否(追跡しないよう要求)を選択してください。
Q2:企業がプライバシーポリシーを改定する際、最も重視すべき点は何ですか?
A2:利用目的の具体性と透明性です。「サービス向上のため」といった曖昧な記述を排し、「生成AIの学習モデルへの利用有無」「第三者提供先における名寄せの可否」などを平易な言葉で明記し、ユーザーがオプトアウト(拒否)できる導線を分かりやすく設けることが求められます。
Q3:生成AIに入力したデータを学習させない最も簡単な方法は?
A3:各AIツールの設定画面にある「データコントロール」や「プライバシー設定」を開き、「モデルの改善・学習にデータを使用する」といった項目をオフに切り替えてください。また、法人利用の場合は、データが学習に一切利用されないエンタープライズ契約やAPI経由での利用を徹底することが鉄則です。
まとめ:デジタル主権を取り戻すための羅針盤
2026年におけるデータとプライバシーをめぐる課題は、技術の進化とともに一層複雑化しています。しかし、その本質は「自分自身の情報に対する主権(コントロール権)を誰が握るのか」という極めてシンプルな問いに集約されます。
法規制の強化やプラットフォーム側の防御機能は着実に進展していますが、最終的な防壁となるのは利用者一人ひとりのリテラシーと主体的な選択です。デフォルトの設定を過信せず、定期的なアカウント管理と明確な境界線設定を行うことこそが、デジタル社会の利便性を享受しながら自身の尊厳と安全を守り抜く唯一の道筋です。 (出典: データ と プライバシー(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。
